画像は中国語版です。ゲームは日本語・英語・中国語に対応しています。 ゲームに直接進む ↗
01 / 現実の問題
なぜ RAG が必要?
ある企業に、
大量の社内文書があるとします。
社員は文書を一つずつ探す代わりに、
AI に直接質問したい。
仕事で出てくる質問
「製品でこの問題が起きたら、
どう対応すればいい?」
LLM がこれらの文書を最初から知っているとは限りません。
最新の情報を持っているとも限りません。
02 / 基本の考え方
まず資料を探し、それから答える。
RAG(検索拡張生成)は、回答を作る過程に外部の情報を取り入れます。
- 利用者質問する何を解決したい?
- 検索関連資料を探す外部資料から検索する
- LLM に渡す質問 + 見つかった情報モデルが参照できる資料を渡す
- LLM回答を生成するその情報を使って答える
ここで気をつけたいこと
見つかったのが「似ている」資料でも、
必ずしも「回答に役立つ」資料とは限りません。
03 / 説明からゲームへ
今度は、あなたが資料を探す番。
小さなロボットに資料を運ばせて、
選び方の影響を見てみましょう。
複雑なモデルやデータベースは、いったん脇に置きます。
ここではお茶のお店の小さな質問で、現実の複雑さを絞ります。
- 小さなロボット
- 選んだ資料を運ぶ、あなたが操作する役です。LLM でも、完全な検索システムでもありません。
- 机の上の資料
- 営業時間や飲み物の価格など、探せる外部情報です。
- LLM の返信台
- 回答する役が登場するのは第4ステージ。質問と資料を受け取り、返信を作ります。
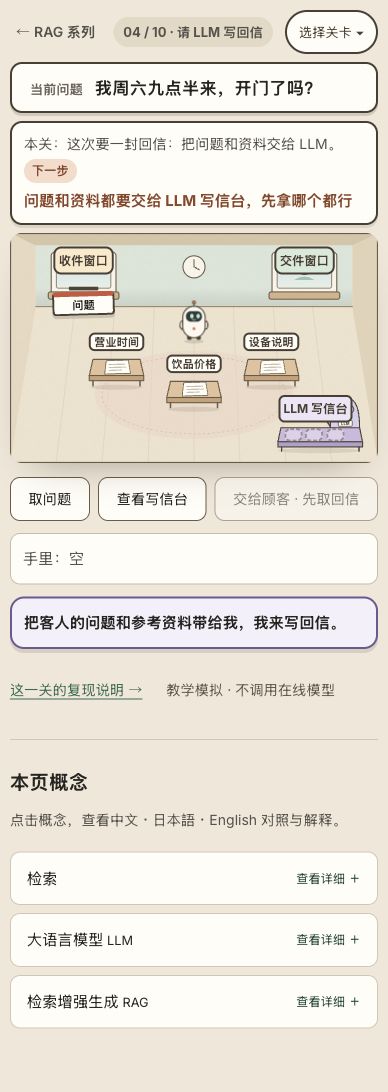
画像を開くと元のスクリーンショットを見られます。
これは結果があらかじめ決まっている学習用シミュレーションです。
資料・検索結果・回答は事前に用意されています。実際の Embedding、検索、LLM は動作しません。
04 / 既存のゲームへ
最初の一歩は、必要な一枚を探すこと。
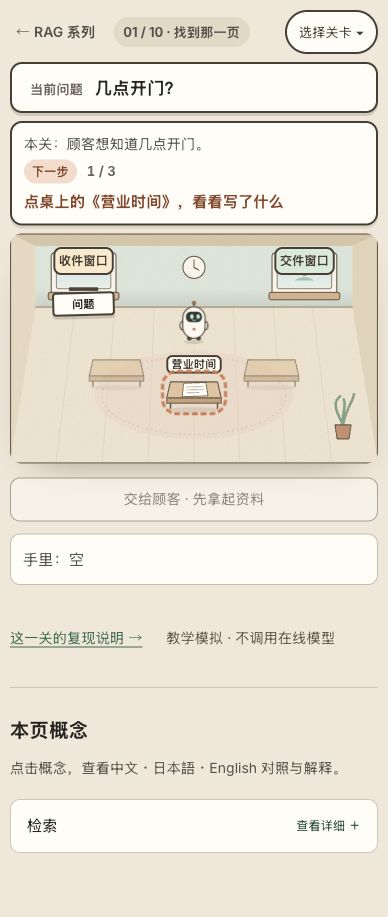
あなたの課題
お客さんの質問:「何時に開店しますか?」
- 今の質問を読む。お客さんが必要としている情報を確かめます。
- 机の上の「営業時間」を選ぶ。スマートフォンでは資料を確認してから取り上げます。PC ではクリックで取れます。
- 資料をお客さんに渡す。スマートフォンでは渡す操作を、PC では交付窓口を選びます。フィードバックとステージの振り返りが表示されます。
第1〜3ステージは、資料を選んで直接お客さんに渡します。
第4ステージで返信台が登場し、第5ステージから検索ツールを使います。資料を間違えたら、フィードバックを見て試し直します。
05 / 振り返り · 体験から理解へ
良い回答は、
モデルだけでは決まらない。
「先頭にあった」あの資料を
覚えていますか?
第5ステージの「新商品のお知らせ」にはタピオカミルクティーが登場しましたが、
価格の質問に答える情報はありませんでした。
回答する側が質問を理解できても、
資料が不適切だったり、必要な根拠が欠けていたりすれば、回答に失敗することがあります。
だから RAG を設計するときは、LLM に加えて、
資料をどう準備し、検索するかも考える必要があります。
このゲームの資料、候補の順序、返信はあらかじめ用意されています。実際の RAG には Embedding、Chunking、検索戦略なども関わります。今回は、その直感をつかむための体験です。
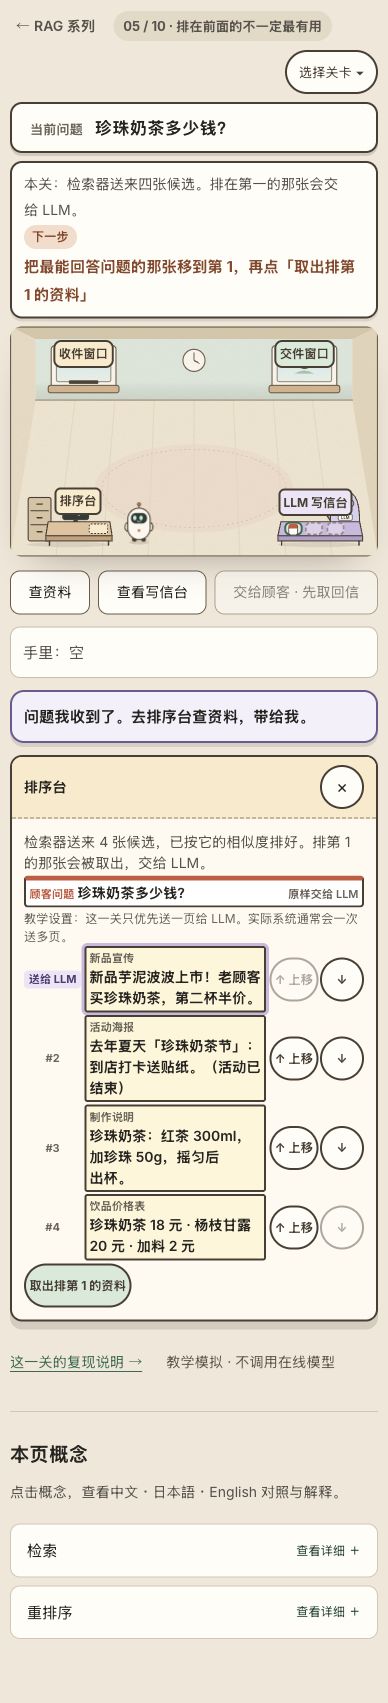
同じ飲み物が登場しても、価格に答えられるとは限りません。